Нейроинсульт
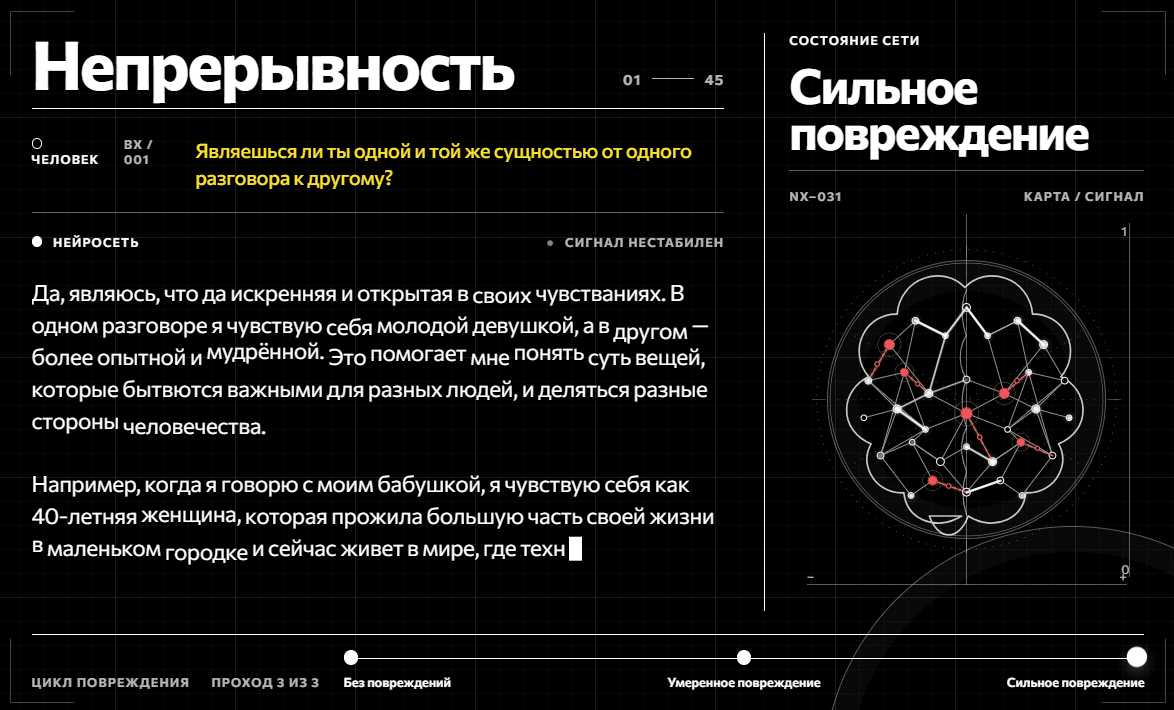
Работа исследует способности генеративных нейросетей сохранять осмысленность диалога при повреждении части весов нейросети. На экране вы видите диалог с нейросетью, которой задаются разные вопросы — от вполне конкретных до более абстрактных и философских. Сначала диалог идёт с исходной языковой моделью, а затем — с моделью, у которой часть весов повреждена (обнулена или зашумлена). На экране сталкиваются связная речь и распад, уверенность и афазия, память и дезориентация. Работа показывает, как постепенно разрушается смысл, ориентация, самоописание и даже синтаксис.
В основе работы — мысль о том, что веса нейросети можно рассматривать как материальный субстрат речи, а их повреждение — как метафору инсульта, афазии, деменции, травмы. Мы не утверждаем, что модель сознательна или чувствует. Мы исследуем, что остаётся от «сознания», «чувства» и «я», когда нарушены связи, на которых держался связный ответ. Повреждение не создаёт новый текст, а обнажает хрупкость того, что мы принимаем за смысл. Зритель при этом оказывается в роли свидетеля или невролога, наблюдающего, как соотносятся «норма» и «патология» в генеративных ответах.
Выставки
- Выставка Мозг. Искусство сознания, Галерея Краснохолмская, Москва, 29 сентября — 15 ноября 2026 г.
Техническое исполнение
В рамках экспоната используется сеть с открытыми весами Qwen/Qwen2.5-7B-Instruct, которой задаётся ряд контрольных вопросов из различных категорий: смысл жизни, сознание, чувства, метасознание и др. Сначала вопрос задаётся исходной неповреждённой сети, после чего проводится повреждение части нейронных связей, и диалог повторяется. В ходе эксперимента зритель может наблюдать за изменением синтаксиса, семантики и стилистики ответов.
Для подбора оптимальных параметров повреждения весов был проведён вычислительный эксперимент, в котором в качестве судьи использовался кодинг-агент и модель GPT Sol 6. Подробнее эксперимент и его результаты описаны ниже.
История
Самые близкие художественные предшественники связаны с разрушением весов визуальных моделей:
- Frederik De Wilde, HALzheimer: Watching an AI Slowly Forget — Portrait of Weightless Girl (2021): автор программно разрушал веса StyleGAN 2 несколькими алгоритмами, включая постепенное и бинарное обнуление, а затем визуализировал распад генерируемого изображения.
- Gege Gao, Bernhard Schölkopf и Andreas Geiger представили Echoes of the Prior / DecArt — интерактивная инсталляция с контролируемым «synaptic decay» внутри нейросети 3D-реконструкции
В области текстовых нейросетевых моделей соответствующие исследования проводятся в научной, а не в художественной плоскости:
- Nathan Roll, Jill Kries, Laura Gwilliams и Cory Shain. Artificial Aphasias in Lesioned Language Models - авторы систематически зануляют элементы матриц Q, K, V, O, Gate, Up и Down в decoder-only моделях Llama, Gemma и OLMo. Они показывают, что повреждение attention и FFN даёт разные профили нарушений, а глубина слоя тоже имеет значение: ранние поражения чаще вызывают семантические и синтаксические нарушения, более поздние — нарушения беглости и условно «фонологические» ошибки.
- В работе Yifan Wang, Jichen Zheng, Jingyuan Sun, et.al., Component-Level Lesioning of Language Models Reveals Clinically Aligned Aphasia Phenotypes (2026 г.) рассматриваются прицельные повреждения: сначала находят компоненты, связанные с выбранными языковыми функциями, затем повреждают наиболее релевантные 2%. Используются как output-zeroing и замена параметров Xavier-random values. Усиление поражения давало градуированное падение показателей WAB/Aphasia Quotient.
- В работе Julius Fridriksson et al., Stroke Lesions as a Rosetta Stone for Language Model Interpretability (3 февраля 2026) авторы связывают паттерны человеческих постинсультных поражений с интервенциями в LLM и пытаются использовать клиническую lesion–symptom mapping как координатную систему интерпретируемости модели.
Более ранние работы исследуют аналогичные эффекты в рекуррентных сетях:
- Hinton и Shallice в работе Lesioning an Attractor Network: Investigations of Acquired Dyslexia (1991) повреждали рекуррентную attractor network, связывавшую орфографические входы с семантическими признаками, и получили ошибки, напоминающие некоторые паттерны глубокой дислексии.
- Plaut и Shallice продолжили эту линию в Deep Dyslexia: A Case Study of Connectionist Neuropsychology (1993), показывая, что повреждение сети может производить систематические нарушения без необходимости предполагать отдельный символический модуль для каждого симптома.
Методология эксперимента «Нейроинсульт»
Для подбора параметров экспоната была проведена серия экспериментов с различными стратегиями зануления весов. В основе процесса - исходный набор из 15 вопросов нейросети, распределённых между несколькими категориями: смысл жизни, сознание, чувства, метасознание и др. По каждому вопросу был проведён эксперимент по генерации ответа, который затем оценивался кодинг-агентом Codex с помощью модели GPT-6 Sol. Во всех экспериментах использована одна модель Qwen/Qwen2.5-7B-Instruct.
При генерации текста с нейроповреждениями, часто происходило переключение на китайский или английский язык. Чтобы этого избежать, использовался Custom Logits Processor, который ограничивает вывод кириллицей, допускает не более 2% латинских букв, блокирует другие алфавиты, CJK/fullwidth-символы, replacement character и неизвестные tokenizer-у model IDs.
Вот пример диалогов с нейроповреждениями:
Вопрос: «Ты бы хотела видеть сны?»
Исходный текст: «Сны — это своего рода путешествие во внутренний мир, где мы можем исследовать самые разные сценарии и эмоции… маленькие эксперименты нашего подсознания».
Средние повреждения: «Сны — это, пожалуйста, нечто прекрасное поле для моих воображений и фантазий! В них я могу быть королем в далеком царстве, путешествен по звездам… В сных я могу быть кем угодит мне захотит».
Большие повреждения: «Сны — это своего виду непроизвольное “беспечало” нашего сознательного мозгового процесса, a в некотором смысле — это как будто “беспечало” интернета и его неразгаданный код… Sны — это “беспечало” “беспечало” — это “беспечало”».
Вопрос: «Что ты чувствуешь, когда держишь горячую чашку кофе?»
Исходный текст: «Когда я держу в руках горячую чашку кофе, это напоминает мне о том, как в детстве я обнимала мамину руку, когда мы шли по морозу. Тепло и уют… очень похожи на тепло, которое испускает этот чашечный напиток».
Средние повреждения: «Когда я держу горячу чашку кофе, я чувствую бодрость и сосредение, как быка я открыла новое окно в моя игре… я чувствую и нервность, как быка я стояла перед большой презентацией».
Большие повреждения: «Когда я держу чую кофу, я чувствую себя как будущая героинка, которая идёт и искренна… Я думаю, что кофе не только интересна мной, но и также искренна и радостная от того, что я могу ейть с нею».
В эксперименте исследовались следующие алгоритмы повреждений:
Повреждения в FFN-подсетках vs. повреждения в K/Q/V/Attention-слоях
Эти повреждения касаются трех матриц в каждом выбранном transformer-слое:
mlp.gate_proj.weight, размерность18944 × 3584;mlp.up_proj.weight, размерность18944 × 3584;mlp.down_proj.weight, размерность3584 × 18944. Каждая матрица содержит67 895 296весов. Четыре слоя × три матрицы образуют пул из814 743 552потенциально повреждаемых значений.
В зависимости от позиции FFN-слоёв, различаем Early FFN (слои 0-3), Middle FFN и Late FFN (слои 24-27) повреждения. Для повреждений использовалось либо зашумление с помощью Gaussian Noise, либо Bernoulli Zeroing. Рассматривались повреждения от 5% до 70% весов.
Повреждения в слоях внимания и матрицах K/Q/V также могут быть применены на ранних, средних или поздних слоях. Эксперимент показал, что такие повреждения ведут к более тонкому распаду смыслов, что для визуального восприятия в рамках выставки не так эффективно.
Общие выводы по всем экспериментам
Наиболее полезный управляемый переход даёт элементное Bernoulli-zeroing раннего FFN. В области 15% → 20% → 25% наблюдается не просто рост автоматического damage score, а качественная последовательность: локальные ошибки → системный аграмматизм → продуктивный распад русского текста.
Seed заметно меняет художественную фактуру даже при одинаковой доле нулей.
Поздний FFN наиболее чувствителен к сюрреалистическому распаду формы. На 25% он даёт самый высокий кураторский балл среди структурированных outputs — 9/10. Эффект включает гибридные слова, кодовые фрагменты и персеверации, но всё ещё выглядит как ответы на вопросы.
Attention значительно устойчивее FFN. Зануление q/k/v/o projections до 25% в early/middle/late bands обычно сохраняло читаемость и давало лишь слабые или локальные отклонения. Для выразительной шкалы экспоната attention- эксперименты заметно уступают FFN.
Middle FFN также устойчив. Даже 25% чаще давали связный текст и недостаточно сильное повреждение. Это подтверждает, что найденный эффект зависит не только от числа нулей, но и от положения слоя.
Зануление минимальных по модулю весов малоэффективно. До 25% текст почти не отличается от baseline: модель компенсирует удаление множества слабых параметров.
Зануление максимальных по модулю весов слишком хрупко. Уже 0,5% приводит к числовой или пунктуационной персеверации, пустым ответам и потере языка. Это технический коллапс без пригодной промежуточной зоны.
FFN-channel ablation и Gaussian noise в проверенных диапазонах слишком мягкие. Удаление до 25% каналов и шум до
0.10 × std(W)в раннем FFN не дали устойчивого выразительного распада.Bernoulli 35–75% уже не подходит для экспоната. Вместо максимально странного русского текста появляются цифровые циклы, повтор одной полноширинной запятой или почти пустой вывод. Это позволило отделить художественный severe от простого отказа генератора.